Publicado el 26 de agosto de 2026, el artículo de Hugging Face explica cómo entrenar y ajustar modelos de embeddings multivectoriales con Sentence Transformers. La versión 6.0 de esta biblioteca de Python incorpora MultiVectorEncoder, un cuarto tipo de modelo que se suma a los modelos de embeddings densos, dispersos y a los rerankers.
MultiVectorEncoder está diseñado para sistemas de recuperación de interacción tardía al estilo ColBERT. A diferencia de un modelo denso, que comprime todo el texto en un único vector, un modelo multivectorial conserva un vector pequeño por cada token. Durante la comparación, cada token de la consulta busca su mejor coincidencia entre los tokens del documento mediante el operador MaxSim, y las puntuaciones se suman.
Este enfoque mantiene señales de coincidencia más detalladas que pueden perderse al resumir un texto en un solo vector. Según Hugging Face, esa mayor granularidad suele traducirse en una recuperación más sólida, aunque aumenta el tamaño del índice. El artículo remite a otra publicación de la compañía para los detalles sobre arquitectura, codificación, puntuación e indexación de estos modelos.
El ajuste fino permite adaptar el sistema al vocabulario, el estilo de las consultas y los criterios de relevancia de un dominio concreto. El artículo señala diferencias entre búsquedas web, análisis jurídico, búsqueda de código y revisión de literatura científica. También destaca que los modelos multivectoriales pueden aprovechar cantidades moderadas de datos de ajuste específicos del dominio.
La longitud de los documentos es otro motivo para entrenar un modelo propio. Muchos modelos de recuperación publicados fueron configurados para pasajes cortos: los checkpoints clásicos de ColBERT limitan los documentos a 180 o 300 tokens, mientras que varios modelos densos populares usan límites de 256 o 512 tokens. En la evaluación médica descrita en el artículo, los pasajes tenían una media de 941 tokens y la truncación llegó a costar 0,24 puntos de NDCG@10.
El flujo de entrenamiento reúne varios componentes: el modelo, los datos de entrenamiento y evaluación, la función de pérdida, los argumentos de entrenamiento, el evaluador y la clase Trainer. Todo el procedimiento mostrado puede ejecutarse instalando el paquete con pip install -U "sentence-transformers[train]".
Sentence Transformers permite partir de un modelo multivectorial existente. El ejemplo utiliza lightonai/mLateOn-unsupervised y configura el modelo para trabajar en precisión float32 cuando la memoria disponible lo permite. También establece un límite de 8192 tokens en el procesador. El artículo recomienda revisar la configuración de longitud, ya que algunos checkpoints mantienen límites específicos para consultas y documentos.
Cuando esos límites no son necesarios, el usuario puede dejarlos sin configurar para que la truncación dependa del máximo admitido por el tokenizador. El ejemplo también añade una lista de omisión con signos de puntuación para excluirlos de la puntuación y del almacenamiento en el lado de los documentos. En la prueba descrita, esta modificación redujo un 9,6 % el tamaño del índice y produjo una mejora modesta en la calidad.
La segunda opción consiste en construir un modelo a partir de un transformer base. El ejemplo emplea answerdotai/ModernBERT-base. En este caso, MultiVectorEncoder añade una proyección de tokens inicializada aleatoriamente, que después puede entrenarse con los datos del dominio.
Hugging Face también presenta una evaluación médica en la que el modelo ajustado multi-vector-encoder/mLateOn-medical fue entrenado durante 14,5 horas en una única GPU RTX 3090. En esa prueba, el modelo superó a los modelos de recuperación de propósito general que se compararon, incluidos modelos densos, dispersos, léxicos y multivectoriales. El artículo procede de Hugging Face y está disponible en https://huggingface.co/blog/train-multi-vector-encoder.
Fuente: Hugging Face
Más noticias
 Más inteligencia artificial para controlar a los agentes descontrolados
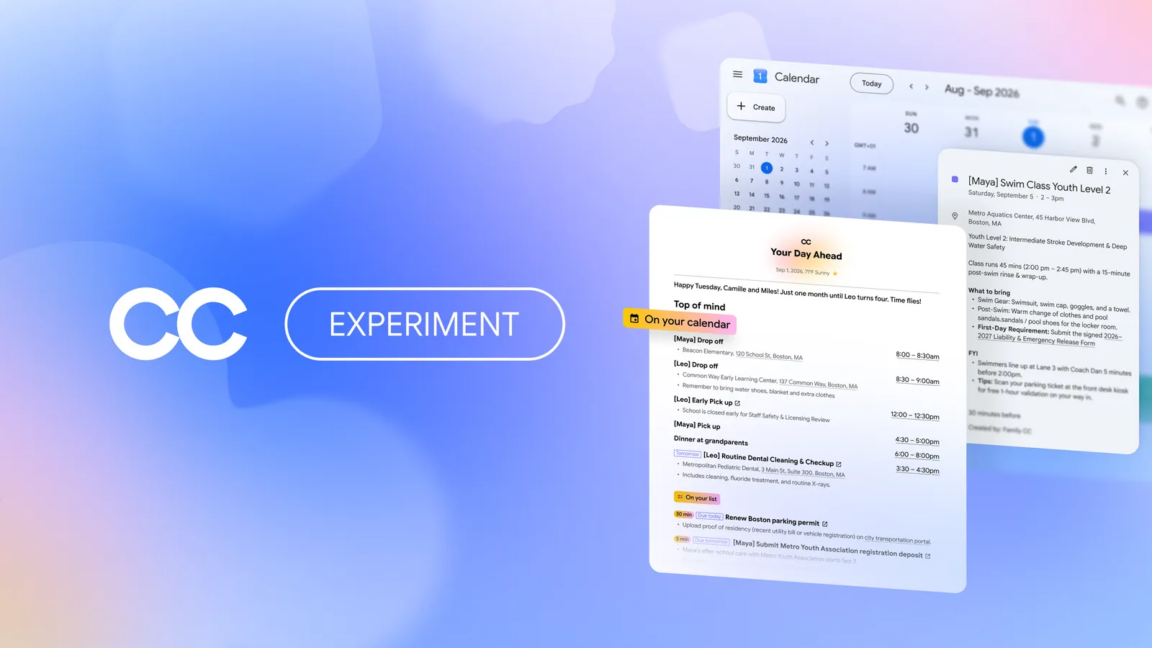 Google prueba CC, un agente de IA para organizar la vida familiar
 Trump plantea rebautizar la inteligencia artificial y crear una AI Force
 El primer evaluador integrado de Anthropic será Accenture
 El Gobierno federal de Estados Unidos retiró una herramienta china de búsqueda basada en IA