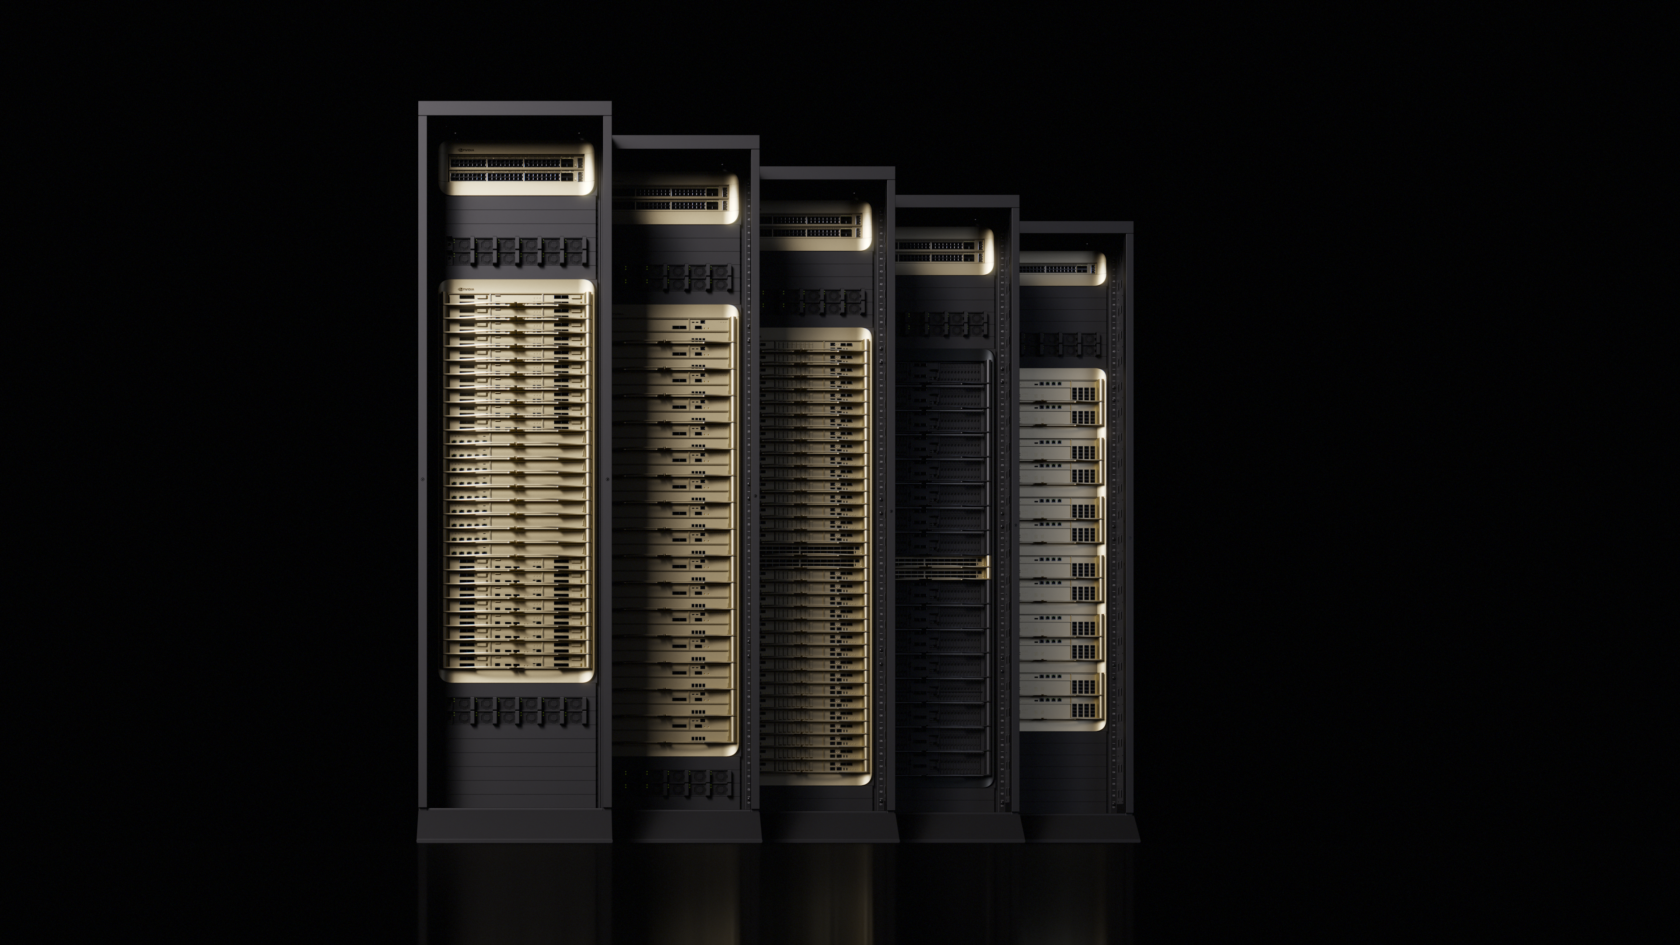
NVIDIA anunció el 24 de agosto de 2026 que su sistema a escala de rack NVIDIA Groq 3 LPX ha entrado en producción completa como una extensión de la plataforma NVIDIA Vera Rubin NVL72. La compañía orienta esta arquitectura a la inferencia de sistemas agénticos, que generan más tokens, trabajan con ventanas de contexto mayores y colaboran con otros sistemas de IA para resolver tareas complejas.
En una prueba de Artificial Analysis con Gemma 4 31B, un modelo agéntico de código abierto, NVIDIA Groq 3 LPX alcanzó 3.400 tokens de salida por segundo en casos de uso con contextos de 100.000 tokens. Según la compañía, este resultado fue cuatro veces superior al de la plataforma alternativa más cercana.
La arquitectura combina las capacidades de las GPU NVIDIA Rubin para procesar grandes volúmenes de contexto con la aceleración especializada de NVIDIA Groq 3 LPX para las cargas de decodificación sensibles a la latencia. En los sistemas agénticos, los modelos generan respuestas token a token mientras razonan, utilizan herramientas e interactúan con otros sistemas, por lo que pequeños retrasos pueden acumularse durante cadenas de trabajo complejas.
NVIDIA Groq 3 LPX está diseñada para trabajar junto a NVIDIA Vera Rubin NVL72 y proporcionar una generación de tokens más rápida y predecible. La compañía sostiene que la combinación busca mejorar la capacidad de respuesta de los agentes, elevar el rendimiento de las infraestructuras y reducir el coste de servir inferencia a gran escala.
La plataforma se basa en un enfoque de codesarrollo conjunto de computación, redes y aceleración de inferencia. NVIDIA presenta esta integración como una arquitectura de “fábrica de tokens”, orientada a ofrecer simultáneamente rendimiento, capacidad de procesamiento, integridad de la inteligencia y eficiencia económica. En este diseño, las GPU Rubin y las LPU trabajan de forma coordinada en las distintas capas del modelo.
Una implementación a escala de rack de NVIDIA Groq 3 LPX puede incluir 256 aceleradores LP30 conectados mediante enlaces directos entre chips. NVIDIA afirma que esta configuración crea un motor de inferencia optimizado para cargas agénticas y para el funcionamiento de proveedores de servicios de IA a gran escala.
La compañía también presentó avances de conectividad asociados a Vera Rubin. CoreWeave ha desplegado en producción Spectrum-X Multiplane, una tecnología que conecta racks NVIDIA Vera Rubin mediante varios switches en paralelo para ofrecer redes de IA de alto ancho de banda, planas y sin pérdidas.
Nebius se ha convertido en la primera nube de IA en adoptar NVIDIA Groq 3 LPX. La incorporación a Nebius Token Factory, junto con NVIDIA Vera Rubin NVL72, pretende aumentar el rendimiento de inferencia para aplicaciones como agentes interactivos, sistemas de programación y otras experiencias de IA en tiempo real.
Por su parte, SpaceXAI anunció que utilizará NVIDIA Vera CPUs en su próxima generación de IA agéntica. La empresa prevé desplegar NVIDIA Vera Rubin desde centros de datos terrestres hasta satélites orbitales. Las CPU se destinarán a tareas intensivas en procesamiento, como la orquestación, el uso de herramientas, la ejecución de código, el procesamiento de datos y la simulación.
NVIDIA afirma que Vera Rubin ofrece rendimiento por núcleo, ancho de banda de memoria y un comportamiento predecible bajo carga para ayudar a completar tareas con mayor rapidez y mantener las GPU utilizadas de forma eficiente. La compañía presentó estas capacidades durante la conferencia Hot Chips, celebrada esa semana en Palo Alto, California, como parte de su estrategia para adaptar la infraestructura al crecimiento de la inferencia y los flujos de trabajo multiagente.
Fuente: NVIDIA.
Más noticias
 Trump plantea rebautizar la inteligencia artificial y crear una AI Force
 El primer evaluador integrado de Anthropic será Accenture
 El Gobierno federal de Estados Unidos retiró una herramienta china de búsqueda basada en IA
 Manus busca una valoración de 4.000 millones tras captar 500 millones
 Investigadores usaron Claude de Anthropic para entrar en OpenAI
 Anthropic y Accenture colaborarán en la evaluación independiente de modelos de IA